全景证据进化
三个词,一条研究主线:记下全过程,让每个结论可回溯,再让新证据和专家反馈推动研究持续进化。
不只是发表后的结论。依据了哪些文献、做了哪些设计决策、用了什么数据、怎样分析、如何验证——五类内容都被记录。
每条主张绑定文献、数据与代码;支持与反驳证据并存;无法溯源的内容,不进入研究结论。
新证据出现,受影响的结论自动重新评估;改动只重跑受影响的环节,审阅不通过就退回出问题的地方;专家的每一次修改,验证后沉淀为新能力,下一项研究直接调用。
- 01 · 保持不变问题理解
- 02 · 保持不变证据检索
- 03 · 保持不变研究设计
- 04 · 保持不变数据准备
- 05 · 重跑统计分析
- 06 · 重跑结果解读
- 07 · 保持不变论文审阅
CRP 切点由 3 改为 1 mg/L:只重跑敏感性分析和结果解读,文献检索与数据准备保持不变。
示例课题:基线 hs-CRP 与抑郁症 SSRI 治疗应答。
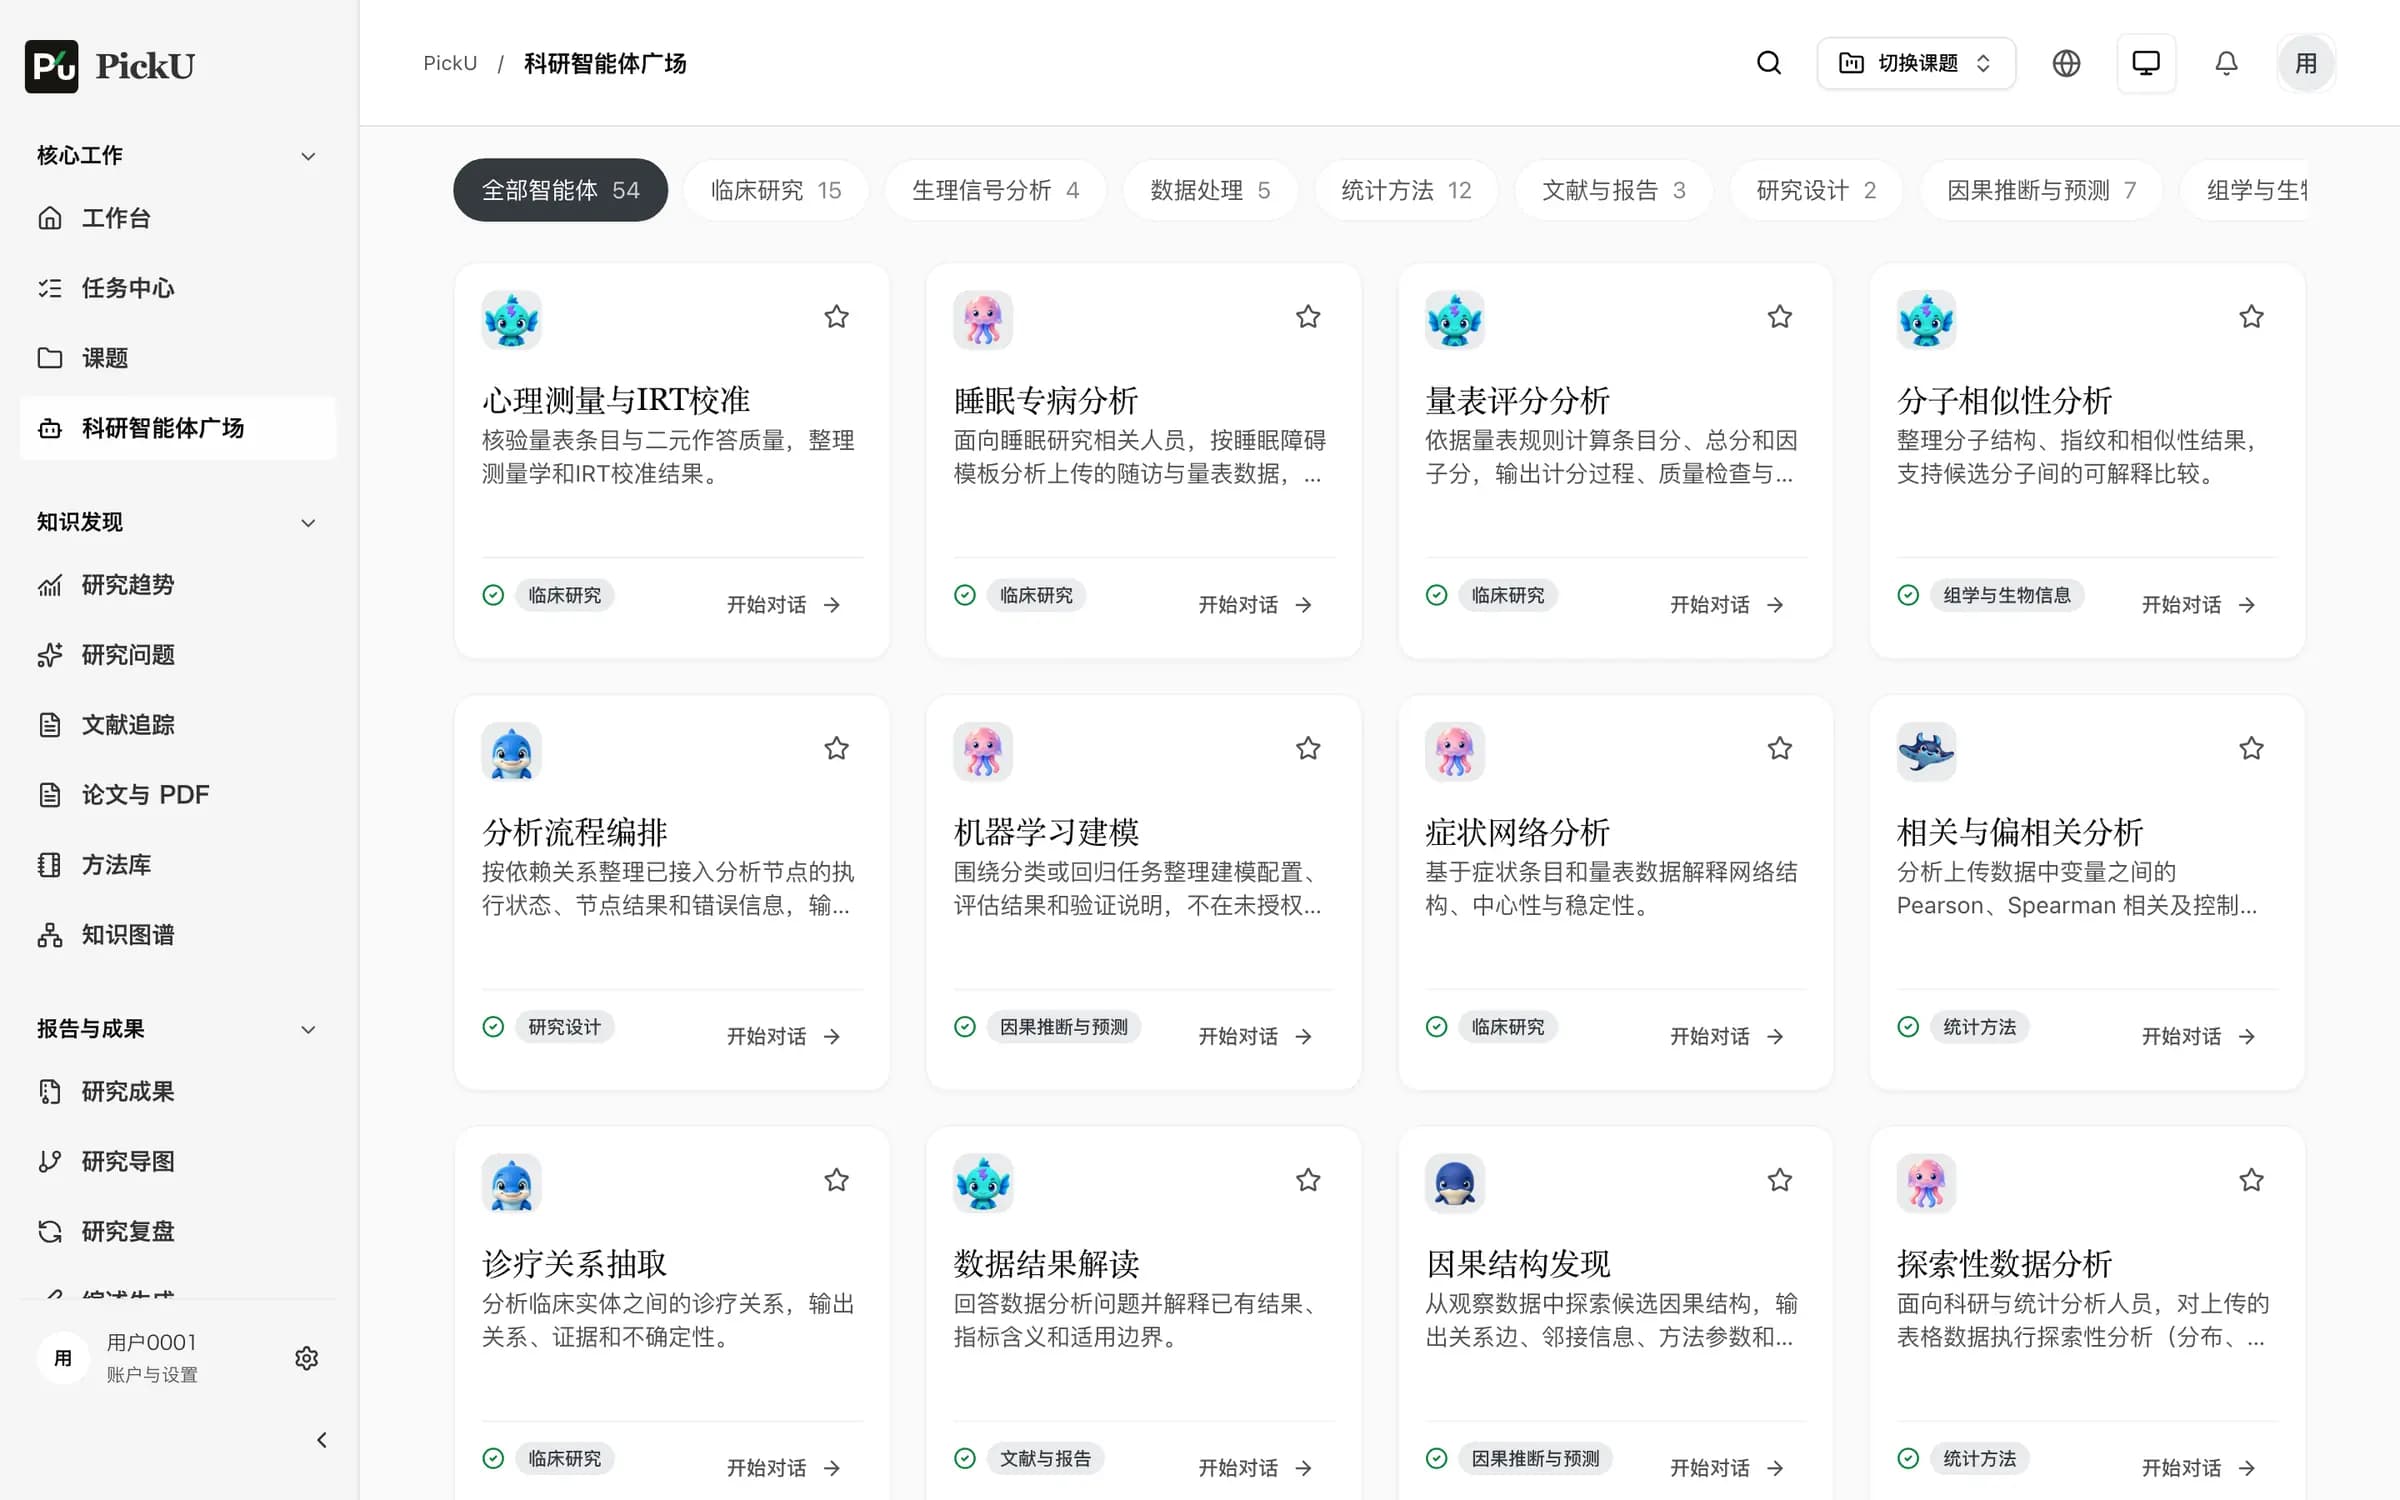
科研智能体
50 多个科研智能体,说清问题就能开工。
从量表评分、生存分析到因果推断与组学,每个智能体专精一类研究任务。上传数据、说清问题,它会先核对数据、再选方法,给出可复核的结果,并写明解释边界。
- 临床研究
- 统计方法
- 因果推断与预测
- 组学与生物信息
- 数据处理
- 生理信号分析
- 文献与报告
- 研究设计
- 说清问题,附上数据用一句话描述研究问题,上传队列文件,智能体先解析字段。
- 先核对,再建模事件、删失、重复记录与风险集逐项核对,每一项都标明依据。
- 关键判断留给你需要人工确认的项目会停下来等你,确认后才进入建模。
演示:研究者向生存分析智能体提出问题并上传随访队列;智能体读取 2,000 行记录,核对字段、重复记录与零时事件,给出核心判断和数据质量表,并把 2 项需要人工确认的问题交给研究者。
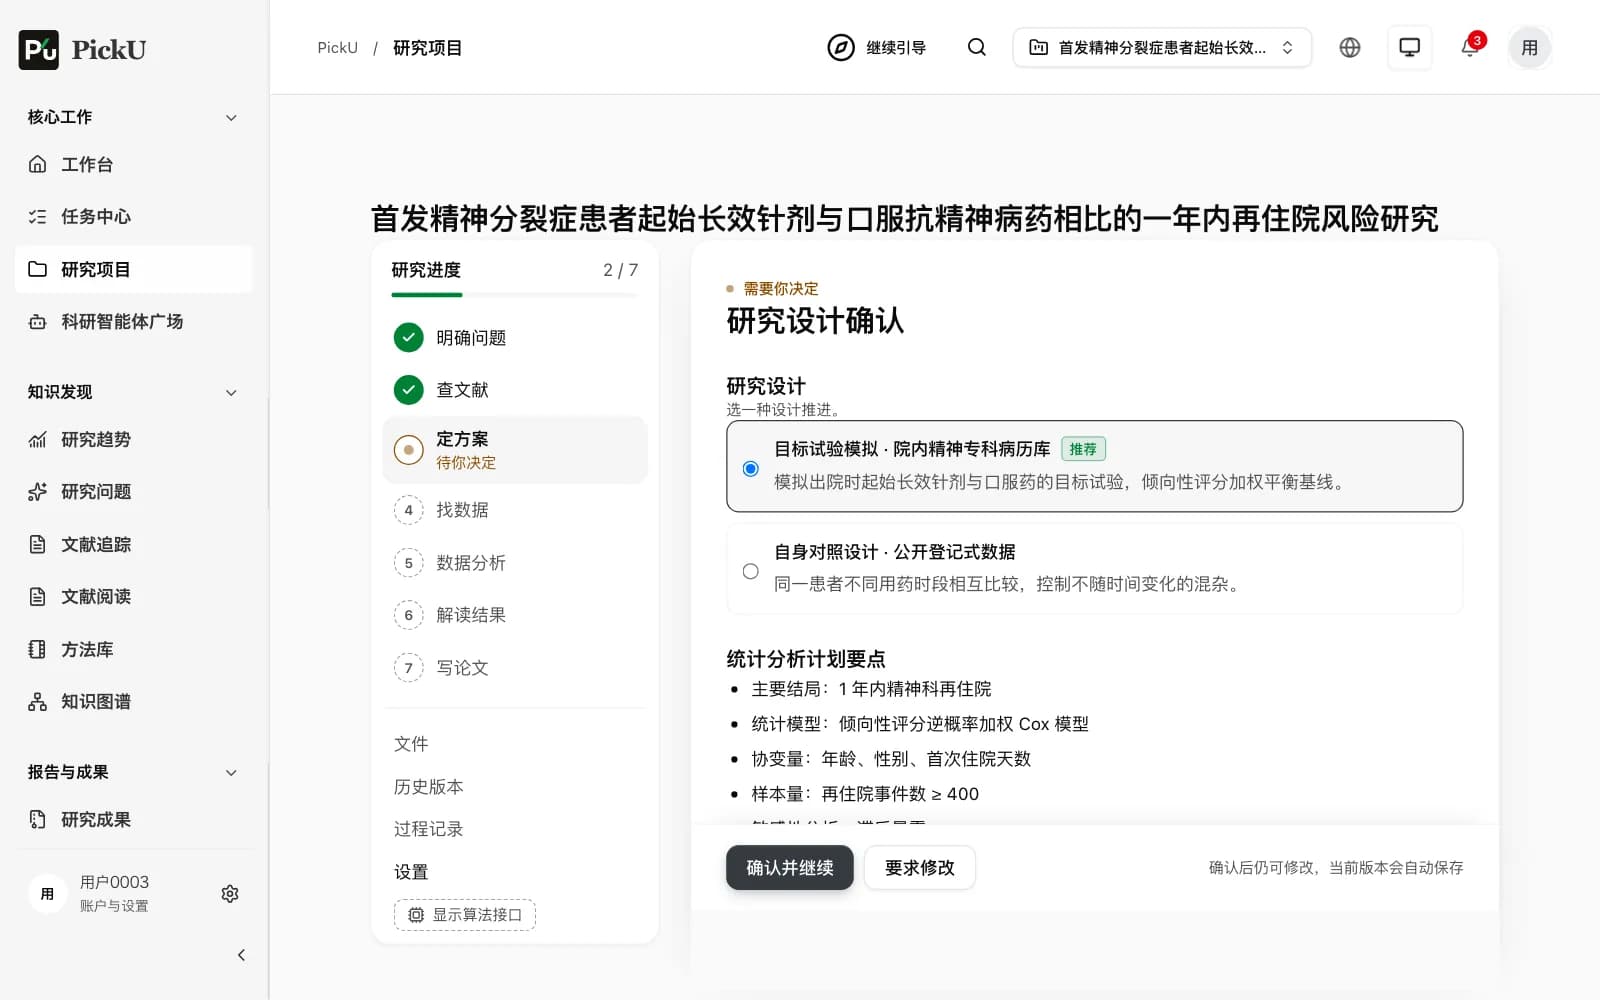
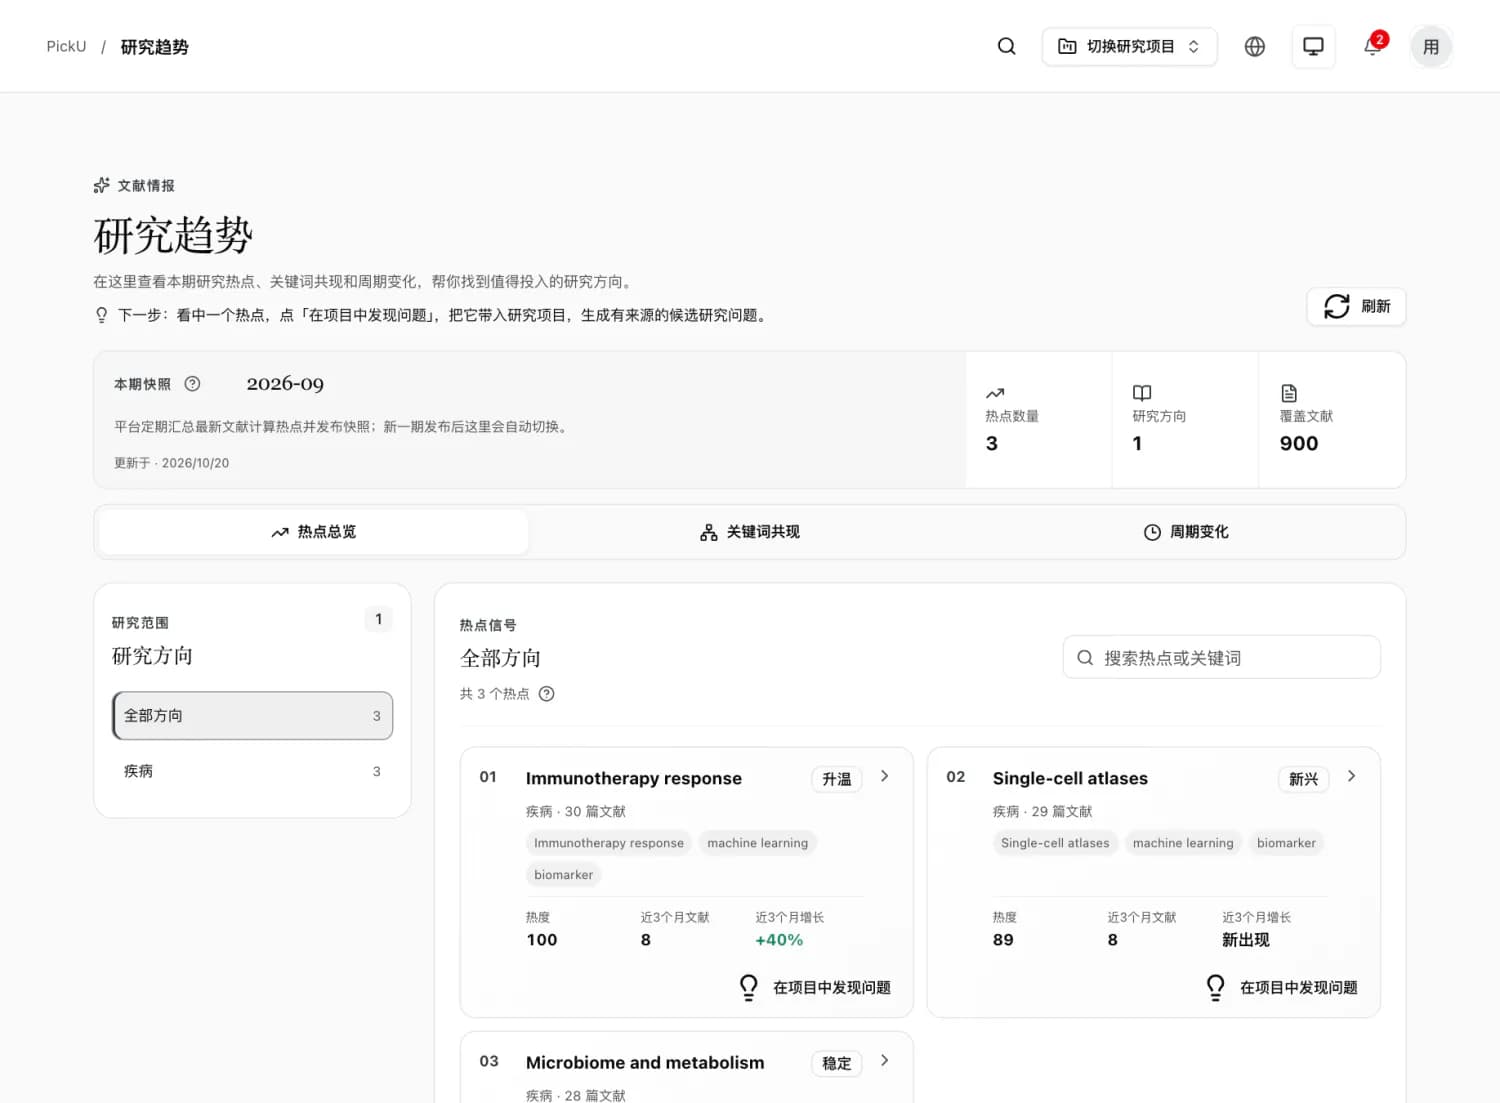
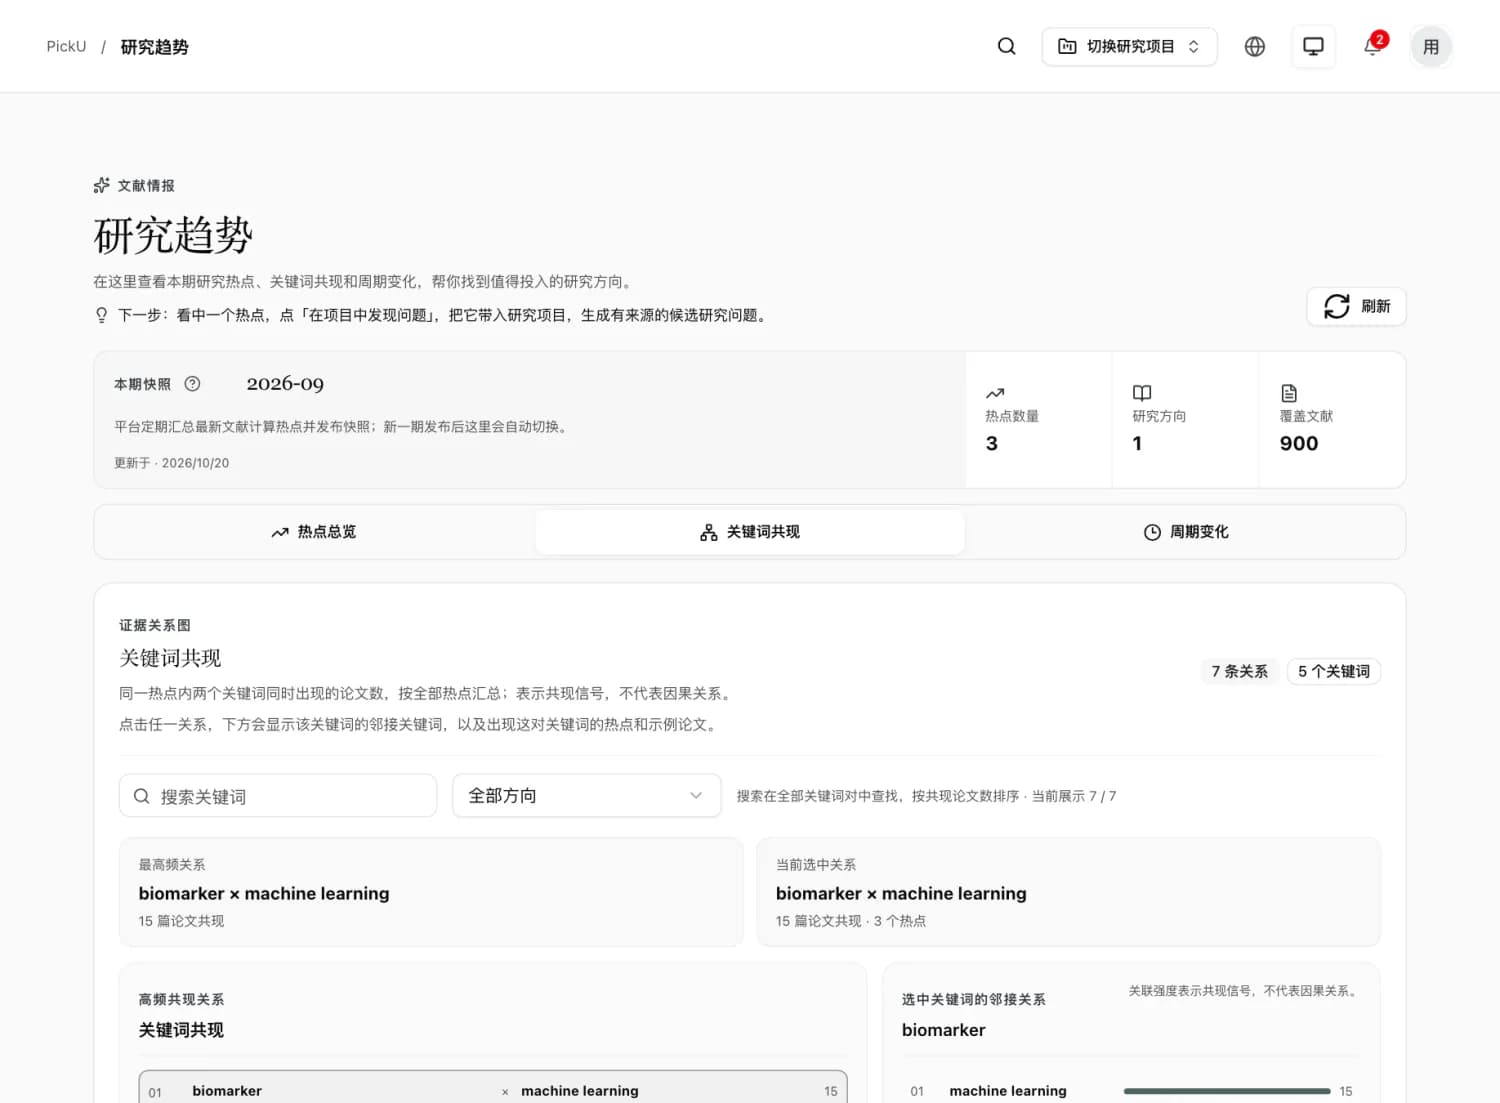
一套研究系统,从问题走向交付。
六项能力共享同一份研究上下文:问题、证据、数据、分析与成果之间的每一次引用都保持连接。
我们为什么做 PickU
科研的瓶颈,早已不是找不到资料。一个问题背后是成百上千篇文献、几十个数据集和不断更新的方法,它们散落在不同的工具、文件夹和人的记忆里。结论越来越难复核,一个项目的经验也很难留给下一个。
PickU 把这些碎片接回同一条链路:从问题出发,每一处引用、每一步数据处理、每一个分析参数都保留来源与版本。智能体承担繁重的检索、清洗与计算,研究者保留每一个关键判断。
研究在交付之后仍在继续。你确认过的方法、修正过的判断、沉淀下来的流程,会成为下一次研究的起点。团队用得越久,PickU 就越懂你的领域,这就是我们说的自进化。
PickU 团队
自进化
每一次研究,
都让 PickU 更懂你的领域。
PickU 会从每一次检索、分析与研究者的判断中学习。用得越久,它给出的方法、证据与流程就越贴合你的研究。
方法库自生长
被验证有效的分析方法与变量定义,自动沉淀为团队可复用的科研资产。
证据权重自校准
根据研究者的采纳与否决,持续调整证据的排序与可信度提示。
工作流自优化
常走的研究路径被总结为可复用流程,下一次一键启动。
所有进化都在研究者确认后生效,每一次变化都可追溯、可撤回。
- 方法库 +1多中心影像的 ComBat 校正研究者已确认
- 证据权重已校准脑龄差相关研究研究者已确认
- 流程模板已更新纵向队列分析流程研究者已确认
研究场景
研究有很多种形态,起点都是一个问题。
精神医学 · 青少年抑郁
产出- 候选选题清单
- 研究空白说明
- 证据强度对比
为严肃的研究而设计。
查看常见问题来源可追溯
每一个结论都能回到具体的论文、数据集与变量版本,便于导师、合作者与评审复核。
保留人工判断
系统负责拆解与执行,关键的研究决策始终由研究者确认,过程完整留痕。
数据按账户隔离
注册需经管理员审核,研究数据按账户隔离,组织内的共享由你决定。
常见问题
还有疑问?
面向需要基于文献与数据开展研究的研究者与团队,覆盖选题、文献、方法与数据、分析建模,到综述申报和成果汇报的完整环节。
让研究的下一步
始终清晰。
进入工作区,让问题、证据、分析与成果沿着同一份上下文持续推进。